Fable 5.2 值得用在哪:编程、数据分析与公开测评解读
解读 Claude Fable 5.2 的编程与长任务能力,梳理 FrontierCode、Plotly 数据分析和 ARC-AGI 公开测评,说明 1M 上下文、API 价格与接入注意事项。
 PicoX 团队发布于
让 AI 写一个函数,和让它接手一项持续几小时的工程任务,中间还隔着不少事情:读懂已有代码、找出真正的约束、修改后跑测试,以及在第一条思路走不通时换个办法。模型有没有把工作做完,往往要到这些环节才看得出来。
11 月 9 日发布的 Claude Fable 5.2,值得放在这样的场景里看。它面向复杂推理和长程智能体任务,支持文本、图像输入与文本输出,提供 100 万 Token 上下文和最高 12.8 万 Token 输出。Anthropic 的模型说明把持续运行的 Agent、多步骤研究和完整交付物列为典型用途。
我更关心的问题是:哪些工作值得用它,哪些成绩可以参考,以及接到自己的项目里还要留意什么。下面结合官方数据与第三方公开测试聊一聊,文中不把公开成绩当作 PicoX 自测结果。
编程能力,要放到整个任务里看
如果一项工作涉及多个模块、历史兼容和复杂依赖,单段代码写得漂亮只是开始。更有价值的是模型能否先摸清调用关系,提出合理改法,最后拿出可以验收的结果。
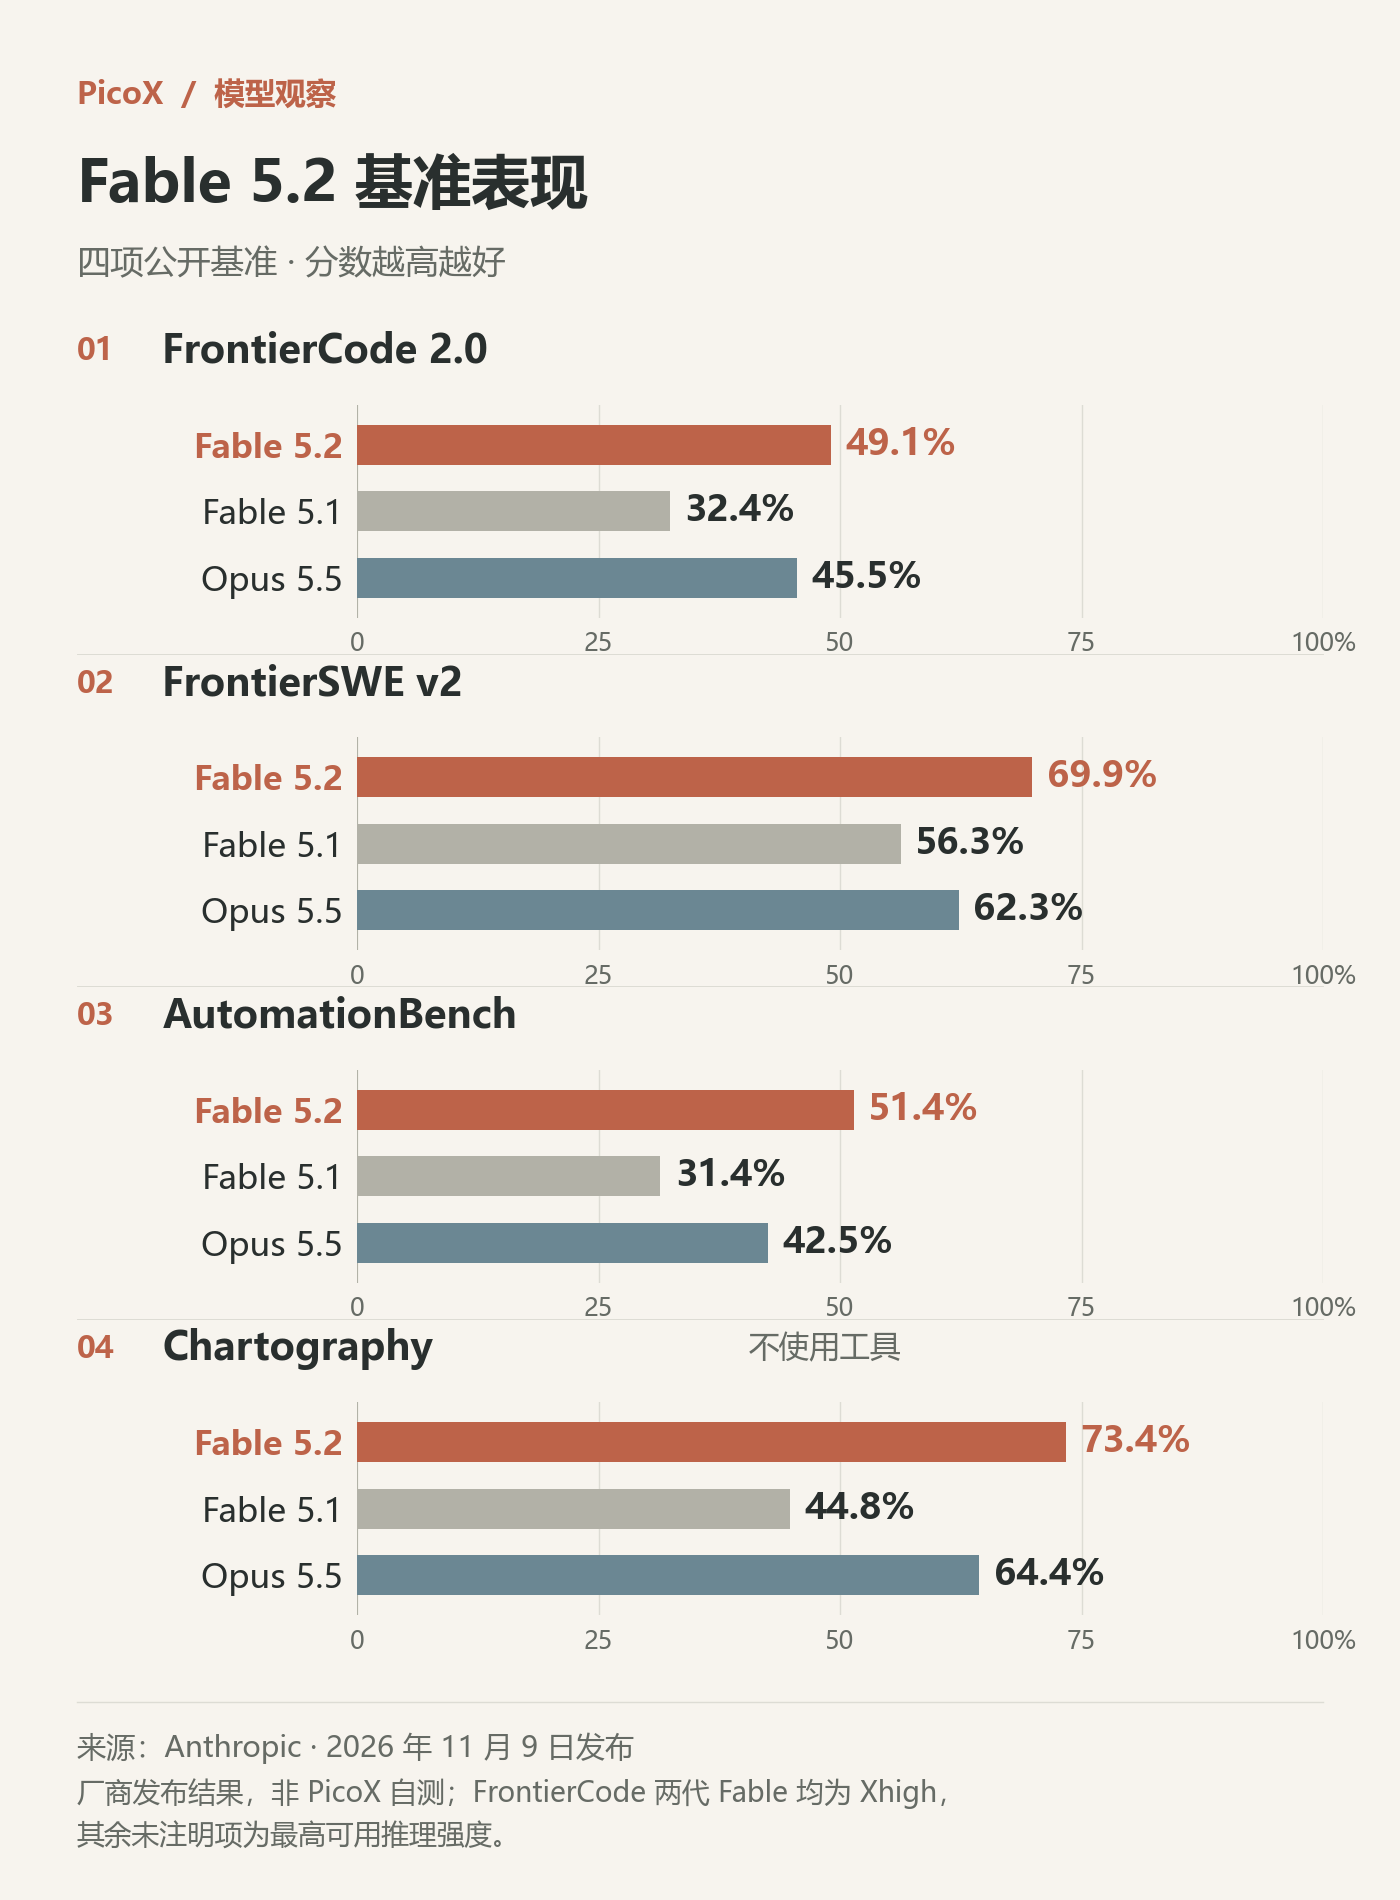
Anthropic 发布表中的几项成绩,能帮助我们判断 Fable 5.2 的进步落在哪里:
展开查看详细成绩
| 评测项目 | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|
| FrontierCode 2.0 | 49.1% | 32.4% | 45.5% |
| FrontierSWE v2 | 69.9% | 56.3% | 62.3% |
| AutomationBench | 51.4% | 31.4% | 42.5% |
| Chartography(不使用工具) | 73.4% | 44.8% | 64.4% |
数据来自 Anthropic 发布说明中的评测汇总,不是 PicoX 独立复测。FrontierCode 2.0 的两代 Fable 使用 Xhigh;其余未特别标注的项目按原表采用各模型最高可用推理强度,测试环境与任务集也各不相同。
编程、业务流程和图表理解都出现了提升,但它并没有包揽每个项目:同一张发布表里,Gemini 4 Carbon 的 AutomationBench 是 53.9%,高于 Fable 5.2 的 51.4%。因此,把这次升级理解成复杂任务上的能力扩展,比笼统地说“所有场景都更强”更合适。
对开发者来说,我会优先拿一项已有验收标准的真实任务试它,例如给老项目补一条跨模块功能,或者修一个能稳定复现、却不好定位的问题。评价重点放在改动能否合并、是否引入回归、需要人介入几次。这样的结果,比让它重复写一道熟悉的算法题更有参考价值。
数据分析测评:满分之外,还要看花了多少时间
Plotly 发布了一份更贴近日常分析工作的测试。Fable 5.2 在 PlotlyDataAnalyticsBench 上答对了全部 43 道题;GPT-6.1 Sol 与 GPT-6 Astra 也拿到了相同成绩。测试围绕一份合成的风电数据,允许模型使用只读 SQL、图表和表格工具。来源:Plotly 测试报告。
这份报告也把代价列了出来:Fable 5.2 完成整轮测试花费 $35.74,单题耗时中位数为 40 秒;同样满分的 GPT-6.1 Sol 对应为 $2.61 和 18 秒。这里是该测试环境记录的整轮花费和单题中位耗时,不能拿来当成 PicoX 的单次请求价格。
我觉得这组结果比单看满分更实在。准确率打平以后,预算和等待时间就成了选型的重要部分。按照 Plotly 的测试方法,每个模型只跑一轮,使用合成数据,也没有置信区间。换成公司的业务表、权限规则和脏数据,仍然要重新验证。
长任务表现,不能只记住一个最高分
ARC Prize 的独立结果很能说明这个问题。在 ARC-AGI-3 上,Fable 5.2 使用标准运行框架、XHigh 推理时得到 81.2%;使用 Provider Adapter 框架、High 推理时得到 97.7%。后者会保留跨请求的推理状态,并对长对话进行压缩。来源:ARC Prize 验证结果。
同一模型在不同框架下,表现会有明显区别。这个比较同时改变了框架和推理档位,不能把差距全归给某一项设置,更不能把 97.7% 写成随便接一个 API 就能达到的水平。
还有一个容易被忽略的细节:标准框架的 Max 设置下,55 个半私有游戏中有 28 个跑满了 12 小时上限,影响了测试进度。对实际项目的启发是,推理强度开到最高并不保证任务更快完成。Agent 怎样保存状态、安排工具调用,以及何时停止等待,都值得一起检查。
它会思考,但接入参数和旧模型不完全一样
Fable 5.2 的自适应思考始终开启,API 默认推理强度为 high。可选档位包括 low、medium、high、xhigh 和 max,在原生 Messages API 中通过 output_config.effort 设置。来源:Effort 文档。
实际接入时,我建议先以默认档位建立基线,再对耗时和成本敏感的任务试较低档位。遇到确实卡住的任务,再提高强度。每次只改一个条件,才容易看出多花的 Token 有没有换来更好的结果。
旧请求配置也需要检查。不要直接沿用手动 budget_tokens 或关闭思考的设置;temperature、top_p、top_k 应省略,强制指定工具的 any / tool 模式也不支持。具体以 Fable 5.2 兼容性说明为准。
多轮工具任务还有一个关键点:返回的思考块及签名要按要求保留,不能随意改写之前的系统提示、工具定义和历史消息。否则,校验失败可能直接得到 400。对正在开发 Agent 的团队,这部分状态管理应该和模型本身一起测试。来源:迁移指南。
价格要看每次任务的完整账单
Fable 5.2 的官方标准 API 单价如下,均以每百万 Token 计:
| 计费项目 | 美元价格 |
|---|---|
| 输入 | $8 |
| 输出 | $40 |
| 缓存读取 | $0.20 |
| 缓存写入,5 分钟 | $10 |
| 缓存写入,1 小时 | $16 |
来源:官方模型规格与定价。以上为标准模式,不包含 Fast mode、工具或其他独立收费项目。
举个便于估算的例子:如果一次请求包含 10,000 个未缓存输入 Token,以及 2,000 个计费输出 Token,按上表计算就是 $0.08 + $0.08 = $0.16。这里的“计费输出”包括思考用量;看不到完整思考文本,也不代表它没有消耗 Token。官方思考计费说明对此有明确解释。
做长任务时,我会把每一步调用的费用加起来,再除以实际完成的任务数。一个模型单价更高,但能少走几轮弯路,未必更贵;反过来,跑出更漂亮的单次答案,也未必足以抵消整条流程的成本。让任务完成率、人工返工时间和总费用放在同一张表里,才容易做决定。
第一次试用,可以从一个小而完整的任务开始
不用急着把整个项目交出去。先选一件你熟悉、结果可验证、过去又确实费过时间的事情:修复一个真实 Bug、核对一份复杂报表,或根据几份文档整理带出处的判断。
把输入材料、验收标准和工具权限固定下来,至少重复几次。记录它是否完成、在哪一步需要你帮助、用了多久、实际花了多少。若是编程任务,保留 diff 和测试结果;若是分析任务,保留 SQL、引用和计算过程。
我会愿意把 Fable 5.2 放进这样的对比里。公开结果已经提供了足够的尝试理由,而是否长期使用,还是要看它能不能把你手头那件麻烦事做得更稳。
资料核对日期:2026 年 11 月 10 日。本文依据 Anthropic 文档及发布数据、Plotly 和 ARC Prize 的公开测试整理;使用建议为编辑判断,未进行 PicoX 独立性能复测。榜单、价格和可用渠道可能继续更新。
在 PicoX.ai 体验 Fable 5.2
Claude Fable 5.2 已在 PicoX.ai 上线,现已开放调用。你可以前往 Fable 5.2 模型页面查看参数、价格和可用供应商,也可以进入 PicoX AI 工作区,从一个自己的真实任务开始体验。
API 接入可查看 PicoX 接入文档,平台模型 ID 为 anthropic/claude-fable-5.2。你也可以在 模型目录搜索 Fable 5.2;实际可用性以账号可选供应商为准。