读懂 DeepInfer:DeepSeek 推理框架的设计、性能与部署边界
DeepSeek 的 DeepInfer 开源了什么?通过架构与调度示意图,解读 Prefill/Decode、DSpark、官方吞吐曲线和硬件要求,了解离线引擎与完整在线服务的区别。
 PicoX 团队发布于
等一个模型回答时,我们通常只看到两件事:第一段文字什么时候出现,后面的内容能不能流畅输出。让这两件事在大量请求同时到来时依然表现稳定,正是 DeepInfer 关注的问题。它把 DeepSeek 在推理引擎上的一部分工程积累放进了公开仓库,也给外部团队留下了一条可以检查、复现和继续优化的路径。
先弄清楚,这次开放了什么
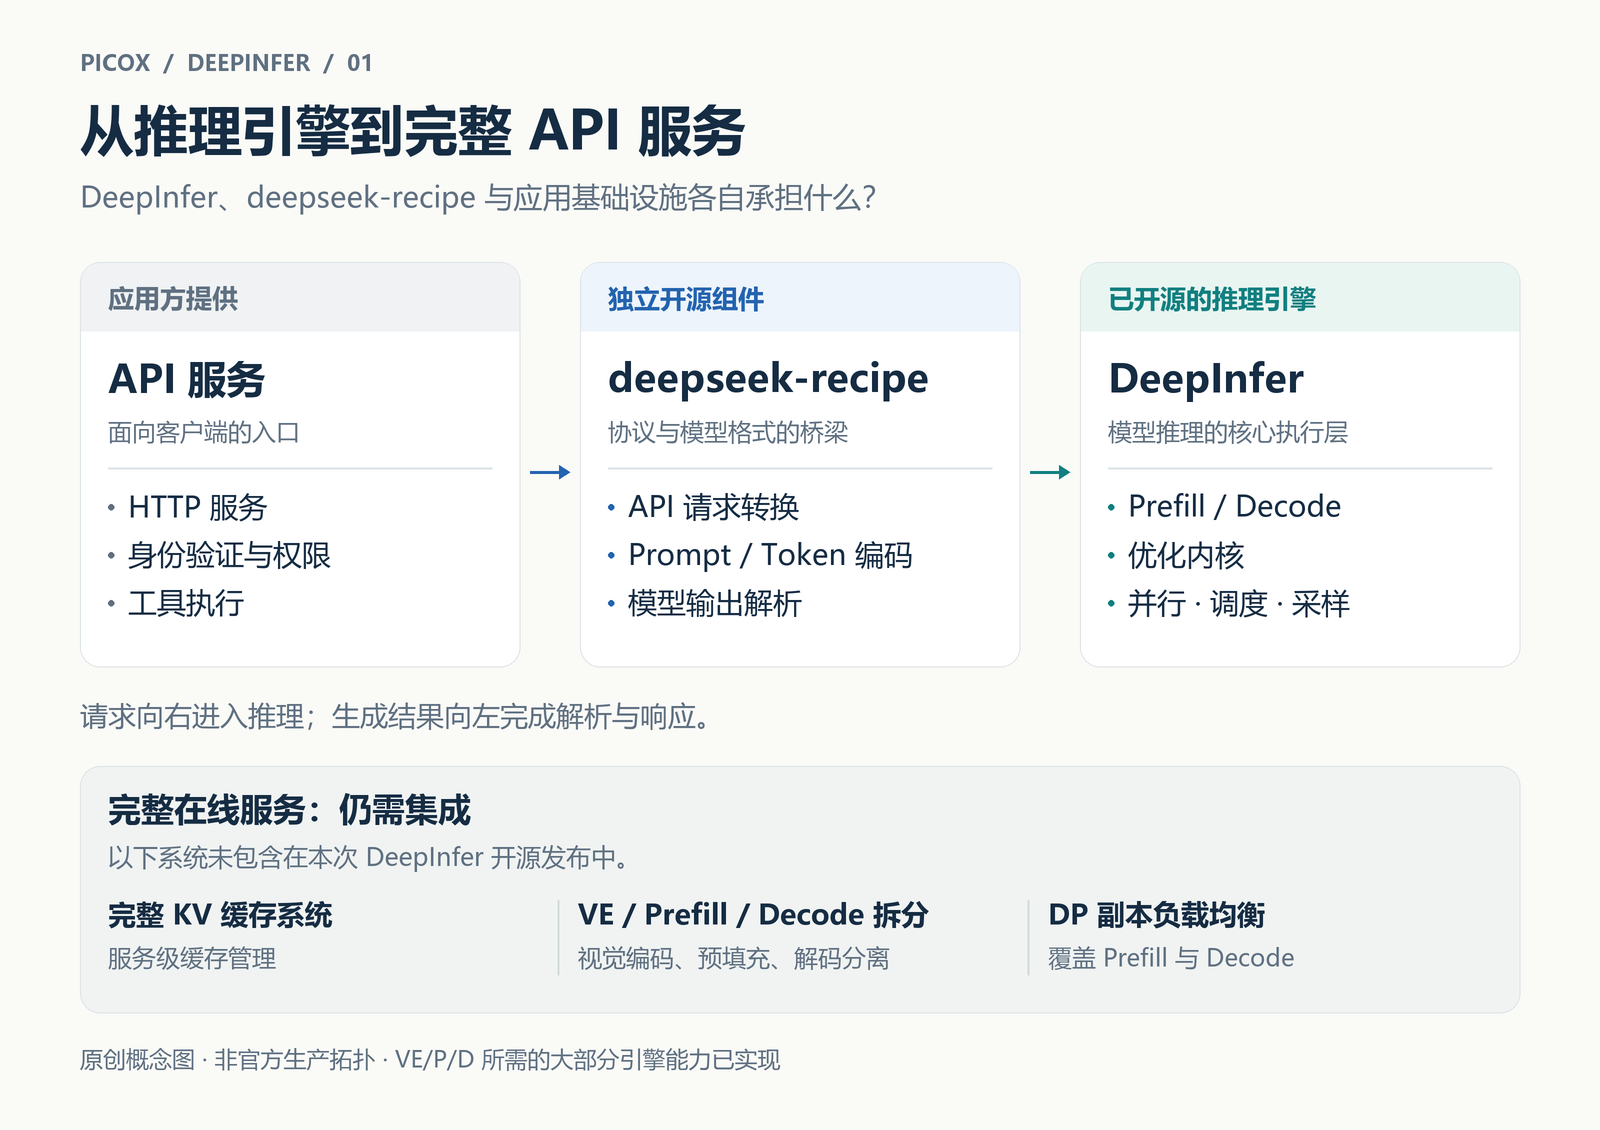
截至 2026 年 10 月 22 日,DeepInfer 的公开版本提供离线推理,支持 DeepSeek-V4.1-Flash,硬件面向 NVIDIA SM100 和华为 Ascend 950。仓库中可以找到模型执行、并行、调度、推测解码等核心能力;要组成完整在线服务,还需要 KV 缓存系统、视觉编码/Prefill/Decode 分离部署,以及跨副本负载均衡等配套。评估接入工作量时,这个边界应该先画清楚。查看官方项目说明。
Prefill 和 Decode,为什么要分开考虑
Prefill 处理输入上下文,Decode 接着逐步生成输出。上传一份长文档和持续生成一段回答,对系统提出的要求并不相同。官方部署问答将视觉编码、Prefill、Decode 分开安排资源;Attention 侧采用数据并行,MoE 侧采用专家并行,并用负载均衡减少忙闲不均。这样才能分别讨论首字等待和后续生成速度。查看部署架构说明。
这也解释了为什么“加几张卡”不能直接换算成相同比例的提速。通信、输入长度、并发量和缓存命中都会改变瓶颈。对准备自建服务的团队来说,先知道用户是在等首字,还是嫌输出太慢,比先选一套最大的并行配置更有用。
值得关注的,是算力怎样被安排
DeepInfer 的异步调度让 CPU 准备后续批次的工作与设备计算重叠;DSpark 则利用草稿 Token 的置信度安排验证,把验证预算分配给更可能被接受的候选。两者处理的是不同的等待和浪费,不能简单相乘成一个“总加速倍数”。官方也给出了部署机制与配置说明。查看 DSpark 与异步调度说明。
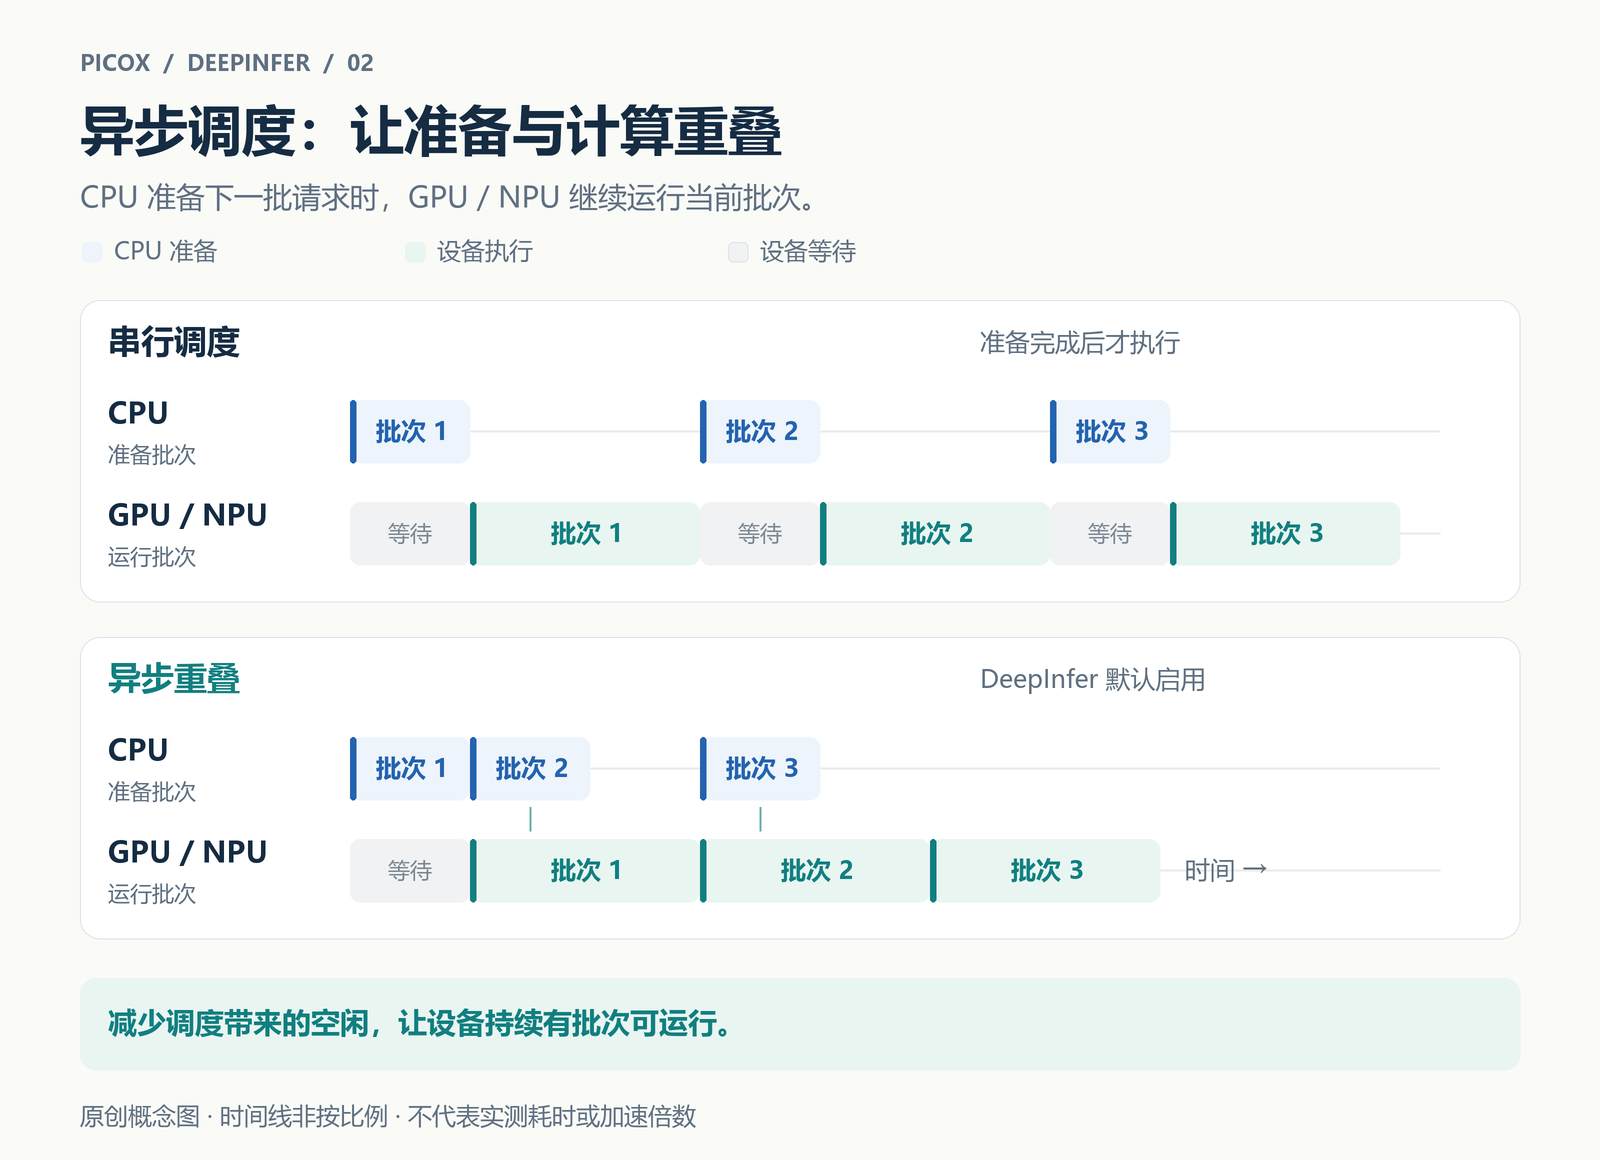
从工程角度看,这些设计很有意思:优化不只发生在某个算子里,也发生在“下一批工作何时准备好”这类容易被忽略的地方。观察整体吞吐时,最好同时看调度空隙和设备执行,才知道时间到底花在哪里。
另外几项能力,也值得在评估时单独记下来。具体开关和限制可对照 官方功能说明:
| 能力 | 阅读时留意什么 |
|---|---|
| EP 与 EPLB | 将 MoE 专家分布到多个设备,并平衡专家负载;效果需要连同通信开销评估。 |
| SWA bounded replay | 通过有限后缀重放减少 decoder 的 Prefill 工作;默认配置里的 140 Token 是保留后缀长度,不是模型上下文上限。 |
| 结构化输出 | 支持正则表达式、JSON Schema 和 EBNF 约束,适合需要固定输出格式的流程。 |
| 批次不变性与确定性采样 | 官方目前限定 NVIDIA;确定性采样需要启用 DEEPINFER_BATCH_INVARIANT=1、关闭变长验证(DEEPINFER_ENABLE_MTP_VARLEN=0),并固定 seq_seed。 |
性能图要连同条件一起读
官方 README 给出两张吞吐曲线:Prefill 使用 4 张 SM100,Decode 使用 64 张 SM100,各自在单个 scale-up 域内测量。它们展示的是推理系统的运行取舍,不能用来判断模型答题能力,也不能直接推算另一套硬件上的表现。查看官方性能图说明。
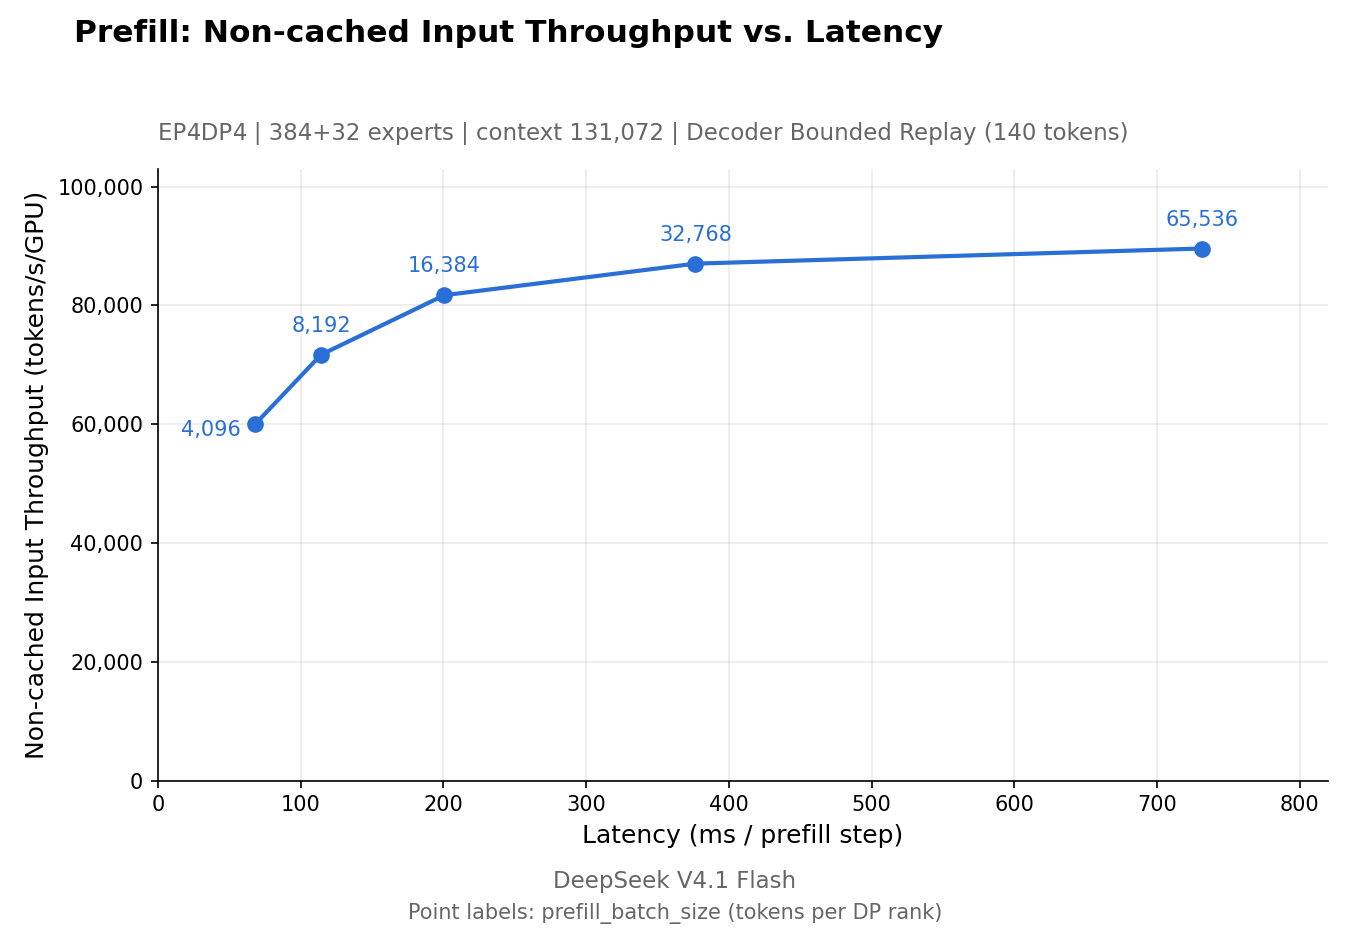

Prefill 图的横轴是每个 prefill step 的毫秒数,纵轴是每张 GPU 的非缓存输入吞吐。一次用户请求还可能经历排队、多个处理步骤和传输,因此这里的横轴不能直接标成“首字用时”。指标定义见绘图代码。
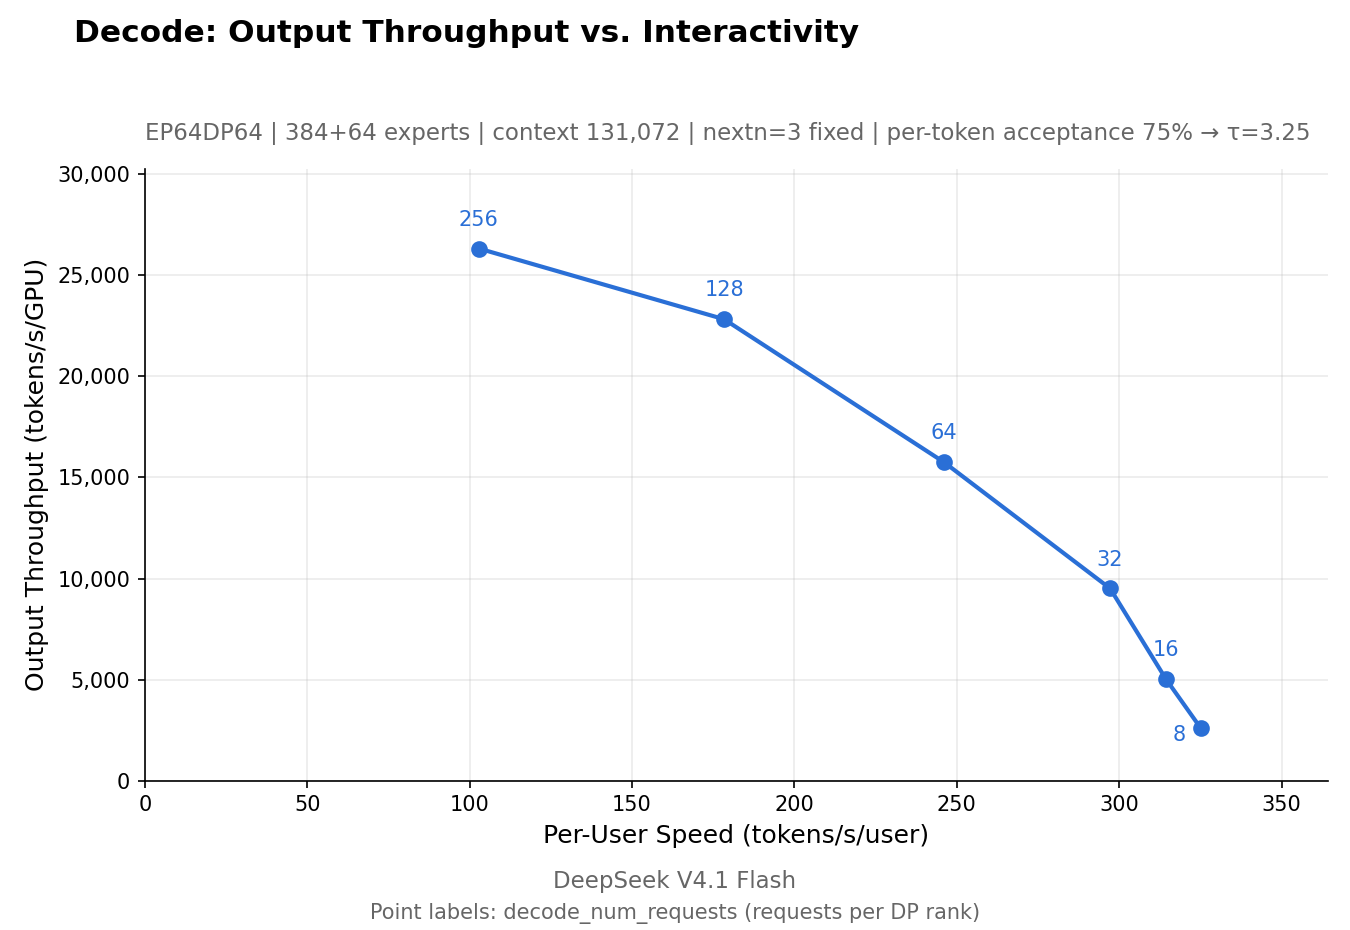

Decode 图把每用户速度和每卡吞吐放在一起。该图按 1 + 3 × 0.75 = 3.25 换算每步的有效 Token 数,两条轴都受这个假设影响。实际请求的接受率变了,换算结果也会变。选择运行点时,应先定用户能接受的输出速度,再看这一点能承载多少吞吐。查看换算方式。
复现的价值,在于能追问结果
最小离线试跑也有明确前提:Linux、GCC 13 或更新版本、干净且已激活的 Python 3.12 环境,以及匹配硬件的软件栈——NVIDIA SM100 使用 CUDA 13,Ascend 950 使用 CANN 9.2。以下是 NVIDIA 分支的起步命令;Ascend 将加速器值改为 ascend。首次运行会下载默认模型权重,需要预留磁盘空间;也可以设置 DEEPINFER_HF_MODEL_DIR 使用本地权重。官方安装前提与说明。
git clone --recursive https://github.com/deepseek-ai/DeepInfer.git
cd DeepInfer
export DEEPINFER_ACCELERATOR=nvidia
./build.sh
python examples/offline_inference.py
仓库的 examples/sweep/run_sweep.sh 会扫描不同批次配置,保存记录并生成曲线;示例文档也解释了预热、稳态测量和 profiler 干扰。准备复现时,建议保留代码版本、硬件拓扑、上下文长度和完整参数,让每个结果都能追溯到一次具体运行。扫描脚本 · 测量口径。
模型质量需要另外检查。eval/ 提供 AIME 2026、HLE、GPQA Diamond 的离线评测流程,并把生成与评分分开。引擎调快之后,用同一套评测配置核对输出质量,比只盯着 tokens/s 更稳妥。查看官方评测流程。
哪些团队值得继续看下去
已有相应硬件、准备部署 DeepSeek 的基础设施团队,可以从离线样例和自己的请求分布开始评估。做 API 接入的团队还可以关注 deepseek-recipe:它负责请求格式、模型提示词与响应之间的转换,推理、工具执行和 HTTP 传输由调用方提供。查看 DeepSeek Recipe。
如果工作主要是调用模型构建应用,最值得带走的是一组更具体的问题:长输入的首字等待怎样,持续输出速度怎样,并发上来后怎样变化。DeepInfer 的公开资料让这些讨论有了代码和测量方法可以对照。本文依据上述官方资料整理,未进行独立性能实测;项目后续变化以仓库为准。