Gemini 4 Carbon 解读:长任务能力、评测表现与使用成本
解读 Gemini 4 Carbon 的长程任务能力、公开评测、共享上下文与 API 价格,说明测试条件和使用边界,帮助判断哪些工作值得交给它。
 PicoX 团队发布于
一个棘手的工程问题,通常要经过读代码、复现、修改、跑测试,才能知道是否真的解决。模型第一轮回答得漂亮,只完成了其中很小的一部分。Google 把 Gemini 4 Carbon 的重点放在了后面的工作:遇到复杂问题时,投入更多推理,持续检查自己的结果。
Carbon 已于 2026 年 11 月 10 日开放使用。不过,Google 同时保留了一个很实际的建议:大多数软件工程和知识工作仍适合交给 Argon,Carbon 面向其中更难、更需要反复验证的任务。这个区分,比一句“新旗舰全面升级”更值得留意。来源:Google 发布公告。
资料核对日期:2026 年 11 月 12 日。本文是基于官方文档和评测机构公开结果的解读,文中分数不是 PicoX 的实测数据。
Carbon 的变化,主要在任务进行到一半之后
按照 Google 的开发文档,Carbon 会在困难问题上使用更多思考 Token,探索不同解释、核对边界情况,再给出答案。代价是单轮 Token 消耗和等待时间可能高于 Argon;默认思考档位为 medium,也可以选择 low 或 high。来源:Carbon 更新说明。
放到实际选型里,我更关心它能否减少返工。比如一次跨模块重构,模型能否发现调用方的假设已经失效;修完一个并发问题后,能否补上能复现旧错误的测试;处理几份互相矛盾的材料时,能否指出冲突,而不是把它们拼成一段顺畅的结论。这些都可以成为你自己评估 Carbon 的题目。
因此,评判它不能只看“有没有生成代码”。更有用的标准是:最终交付是否通过验收,留下多少人工修补,以及整个过程用了多久、花了多少钱。
评测表现不错,但要把分数和条件一起看
代码任务:准确率接近,成本差距更显眼
CursorBench 4.0 的公开榜单中,Carbon High 为 60.4%,Medium 为 60.1%,Fable 5.2 Max 为 60.0%。公布的平均每任务成本分别是 $9.22、$8.49 和 $32.79。这组结果值得看,但 High 与 Fable Max 的分数只差 0.4 个百分点,不能据此断言换个仓库也一定领先。来源:CursorBench 4.0。
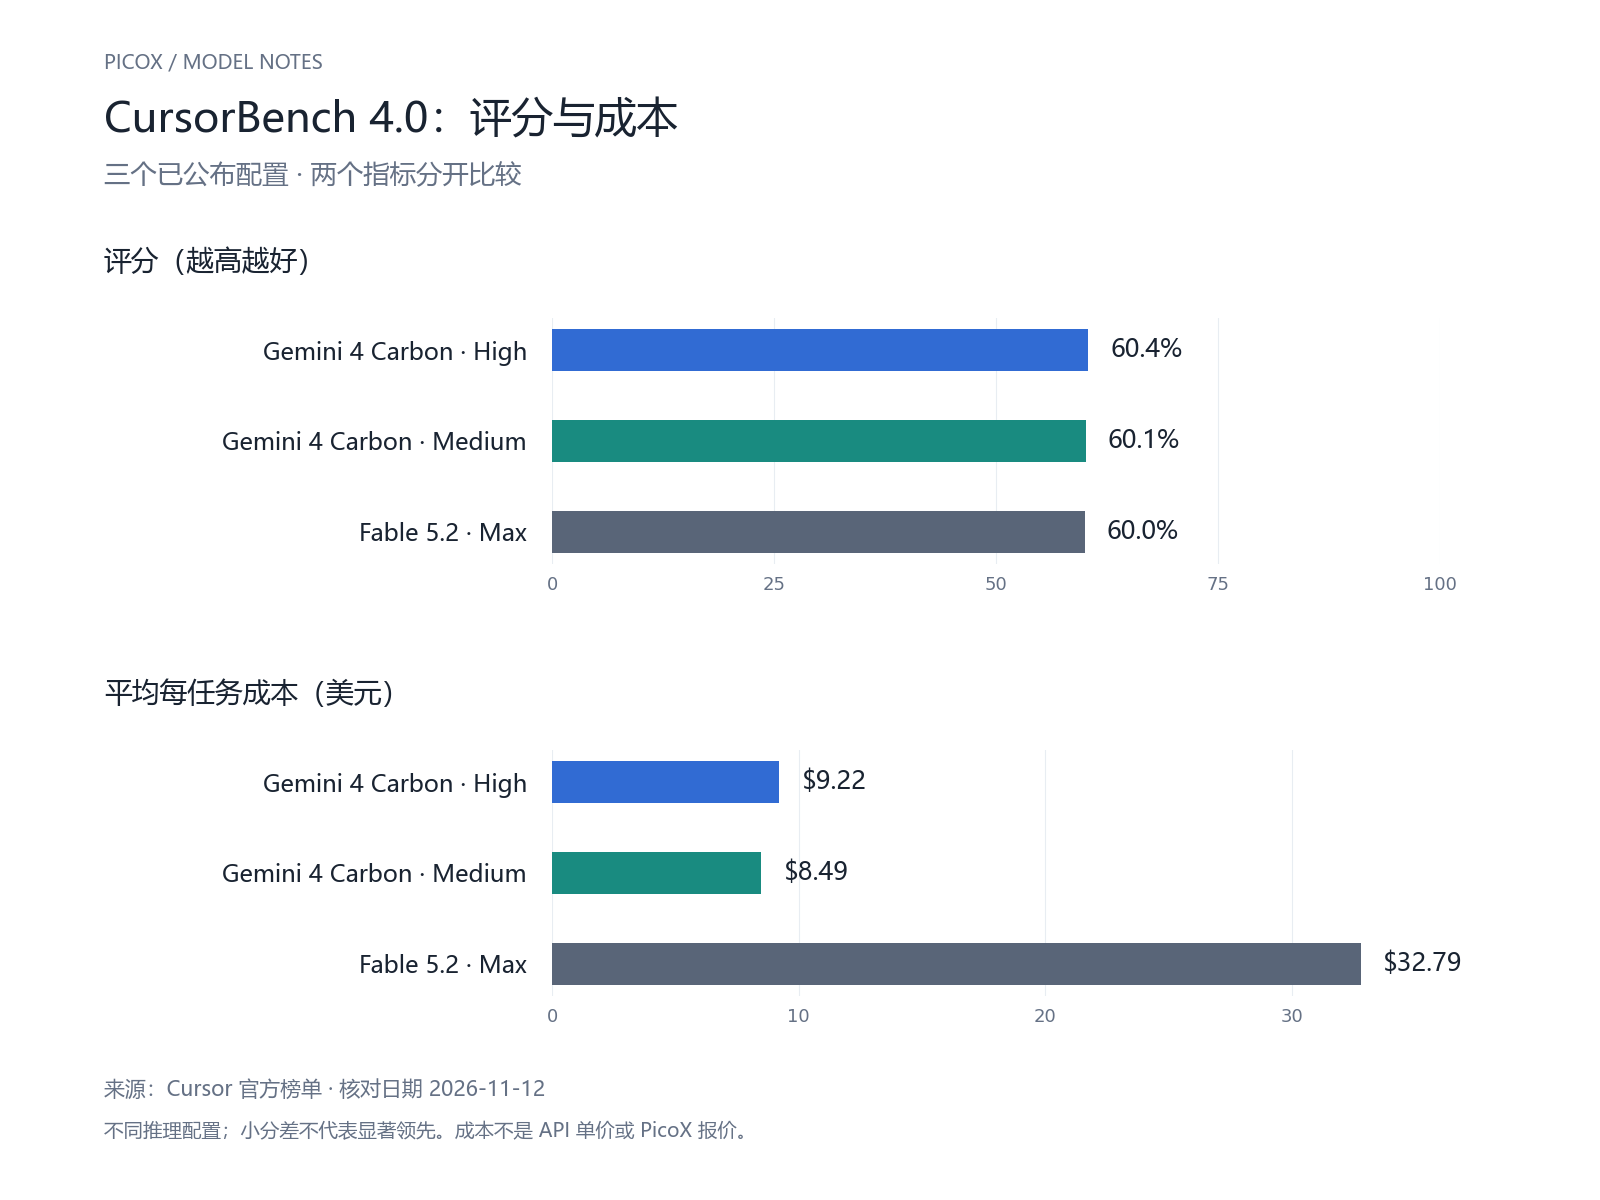
我会把它理解为一个值得加入候选名单的信号:Carbon 可以在这套任务中取得相近的高分,同时表现出较好的成本效率。真正迁移之前,还应该用自己经常遇到的故障、项目结构和验收条件重新测一遍。
Cognition 的 FrontierCode 2.0 也给出了一个参照:Carbon 为 40.0%,Argon 为 26.3%。这里采用的是按评价标准加权的分数,不代表 40% 的真实 PR 可以直接合并。来源:Cognition 评测。
数据分析与自动化:完成度提升不等于每次都更快
Plotly 的数据分析测试中,Carbon 答对了 43 道题里的 42 道,单题用时中位数为 93 秒。评测作者也提醒,这是单次测试,一两分的差距应谨慎解读。对于需要检查统计陷阱的任务,这个结果有吸引力;对于一个需要即时反馈的交互界面,等待时间又是另一笔账。来源:Plotly 自有评测。
Zapier 在发布前(10 月 26–27 日)进行了 AutomationBench 1.0.6 测试:每档 657 个自动化任务,限制最多 50 步,并要求最终状态满足全部断言。Carbon Medium 完成 348 个,High 完成 354 个,约为 53.0% 和 53.9%。至少在这组任务中,把思考档位调到最高,并没有带来同等幅度的成功率提升。来源:Zapier 测试报告。
ARC 的 99.1%,需要连同适配方式一起读
ARC Prize 对 Carbon 的 ARC-AGI-3 测试给出了两种运行环境:Medium 档在 Standard harness 下为 63.9%,使用 Provider Adapter 时为 99.1%。后者会保留跨请求的推理状态,并对长会话进行压缩。同一个模型、同一思考档位,运行方式不同,结果也可能相差很大。来源:ARC Prize 官方结果。
这对做智能体应用的人很有启发:模型选对之后,状态如何传递、历史如何整理、工具如何反馈,仍然需要认真设计。单独摘出最高分,无法告诉我们把模型接入现有程序之后会发生什么。
百万上下文,接口边界也需要看清
| 项目 | 官方说明 |
|---|---|
| 模型 ID | gemini-4-carbon |
| 输入与输出 | 接受文本、图片、音频、视频和 PDF;输出文本 |
| 统一上下文 | 1,048,576 Token,由输入、思考和输出共享 |
| 普通同步生成上限 | 65,536 Token,包含思考与输出 |
| 思考档位 | low、medium、high;默认 medium |
| 缓存 | 支持隐式缓存,不支持显式缓存 |
| 工具与结构化结果 | 支持函数调用和结构化输出;具体接入能力还取决于所用接口 |
来源:Google 模型文档。参数量没有在这里给出,本文也不据此推测模型规模。
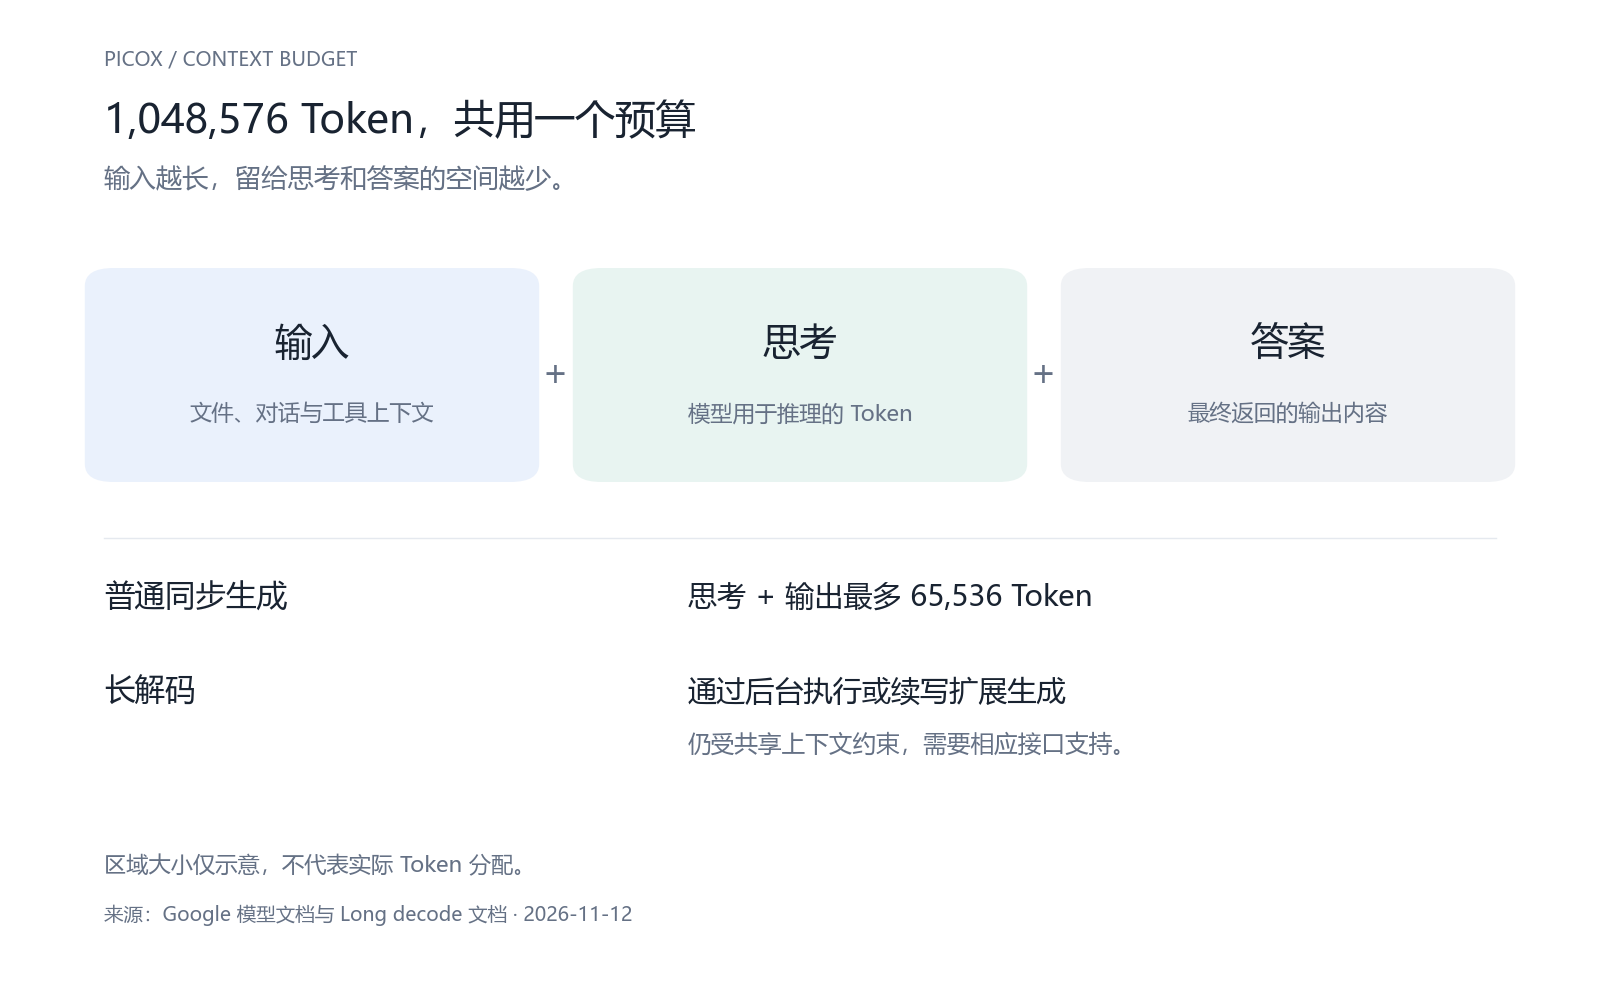
这里最容易误读的是“百万 Token 输出”。普通生成并不会自动给出这么长的结果。超过 65,536 Token,需要使用 Google 的 long decode,通过后台执行或续写完成;输入越长,留给思考和输出的空间越少。这个机制也不能直接等同于任意 OpenAI 兼容接口的行为。来源:长解码文档。
对工程实现而言,我会把长任务设计成可追踪的作业:保留任务 ID、记录进度、明确取消方式,并把中间产物保存下来。这样即使用户关掉页面,也能分清任务是在运行、失败,还是已经完成。
价格要看两个日期,也要看思考用了多少
下面是 Google 标准 API 的美元价格,每百万 Token 计价。输出包含思考 Token,缓存一栏是隐式缓存命中的输入价格。
| 计费项目 | 截至 2026 年 11 月 30 日 | 2026 年 12 月 1 日起 |
|---|---|---|
| 输入 | $2.00 | $4.00 |
| 输出,含思考 | $10.00 | $20.00 |
| 缓存输入 | $0.10 | $0.20 |
来源:Google 官方价格页。这是标准档报价,不包含额外工具费用;Batch、Flex、Priority 等服务档位另有计价。
举个纯计算的例子:同样输入 10 万个未缓存 Token,如果思考加答案一共用了 2 万个输出 Token,按当前标准价是 $0.40;如果通过长解码或续写累积到 8 万个 Token,就是 $1.00。这里没有增加输入,账单仍会明显变化。这是费用示例,不是 Carbon 的实测平均消耗。
所以,我更愿意按“完成一个合格任务的成本”比较模型。一次输出便宜,但后面需要反复补救,未必划算;一次长推理也不一定值得,尤其当简单规则或更快的模型已经能把任务做对时。
我会怎样开始评估 Carbon
先挑一小组真正影响工作的任务:一个有复现条件的代码故障、一份需要交叉核对的资料、一段包含异常分支的工具流程。把验收条件提前写下来,保持输入和工具环境一致,再比较不同模型及思考档位。
记录时,除了是否通过,还要留下首字等待、完整耗时、总费用,以及人工接手了几次。对于偶发成功的题目,值得重复运行。一次令人印象深刻的演示,可以帮助发现用途,却很难代替稳定性判断。
Carbon 值得关注的地方,是它能否承担那些需要持续检查、反复修正的难题。我的倾向是先把它放在这类任务上试用,日常交互继续保留更快的选择。等自己的任务数据说明问题,再决定扩大使用范围。
准备接入时,可以先在 PicoX 模型目录确认当前可用的模型和供应商,再通过接入文档核对调用方式。是否支持 Carbon 的具体接口能力,应以实际可用路由为准。