Gemini 4 Hydrogen 解读:编程与 Agent 评测、上下文和价格
Gemini 4 Hydrogen 值得用吗?结合 Google 官方基准与 Plotly 数据分析评测,比较自动化、桌面操作、答题速度与任务费用,说明百万共享上下文、输出上限、思考档位、API 定价和迁移时需要注意的参数。
 PicoX 团队发布于
选日常干活的模型,我最在意的往往不是某道难题能不能多拿两分,而是改一个 Bug 要等多久,工具报错后能不能接着做,最后还需要我修多少。Gemini 4 Hydrogen 的定位,恰好落在这些问题上。
Google 在 2026 年 11 月 12 日发布 Hydrogen,把它放在日常编程和智能体工作流这一侧,Carbon、Argon 则继续面向需要更深入推理的任务。这并不意味着选型时按名字排个高低就够了。新公布的成绩里,Hydrogen 有亮点,也有明显没赢的项目。Google 发布说明
资料核对:2026 年 11 月 13 日。本文解读官方资料与评测机构公开结果,不是 PicoX 自行跑出的实测报告。
先看成绩:有进步,但不是每一项都领先
先挑三项不同类型的任务来看。Google 公布的对比里,Hydrogen 的自动化和难题成绩有亮点,桌面操作却没有全面领先。它适不适合做你的 Agent,仍取决于 Agent 主要在做什么。Google 模型卡
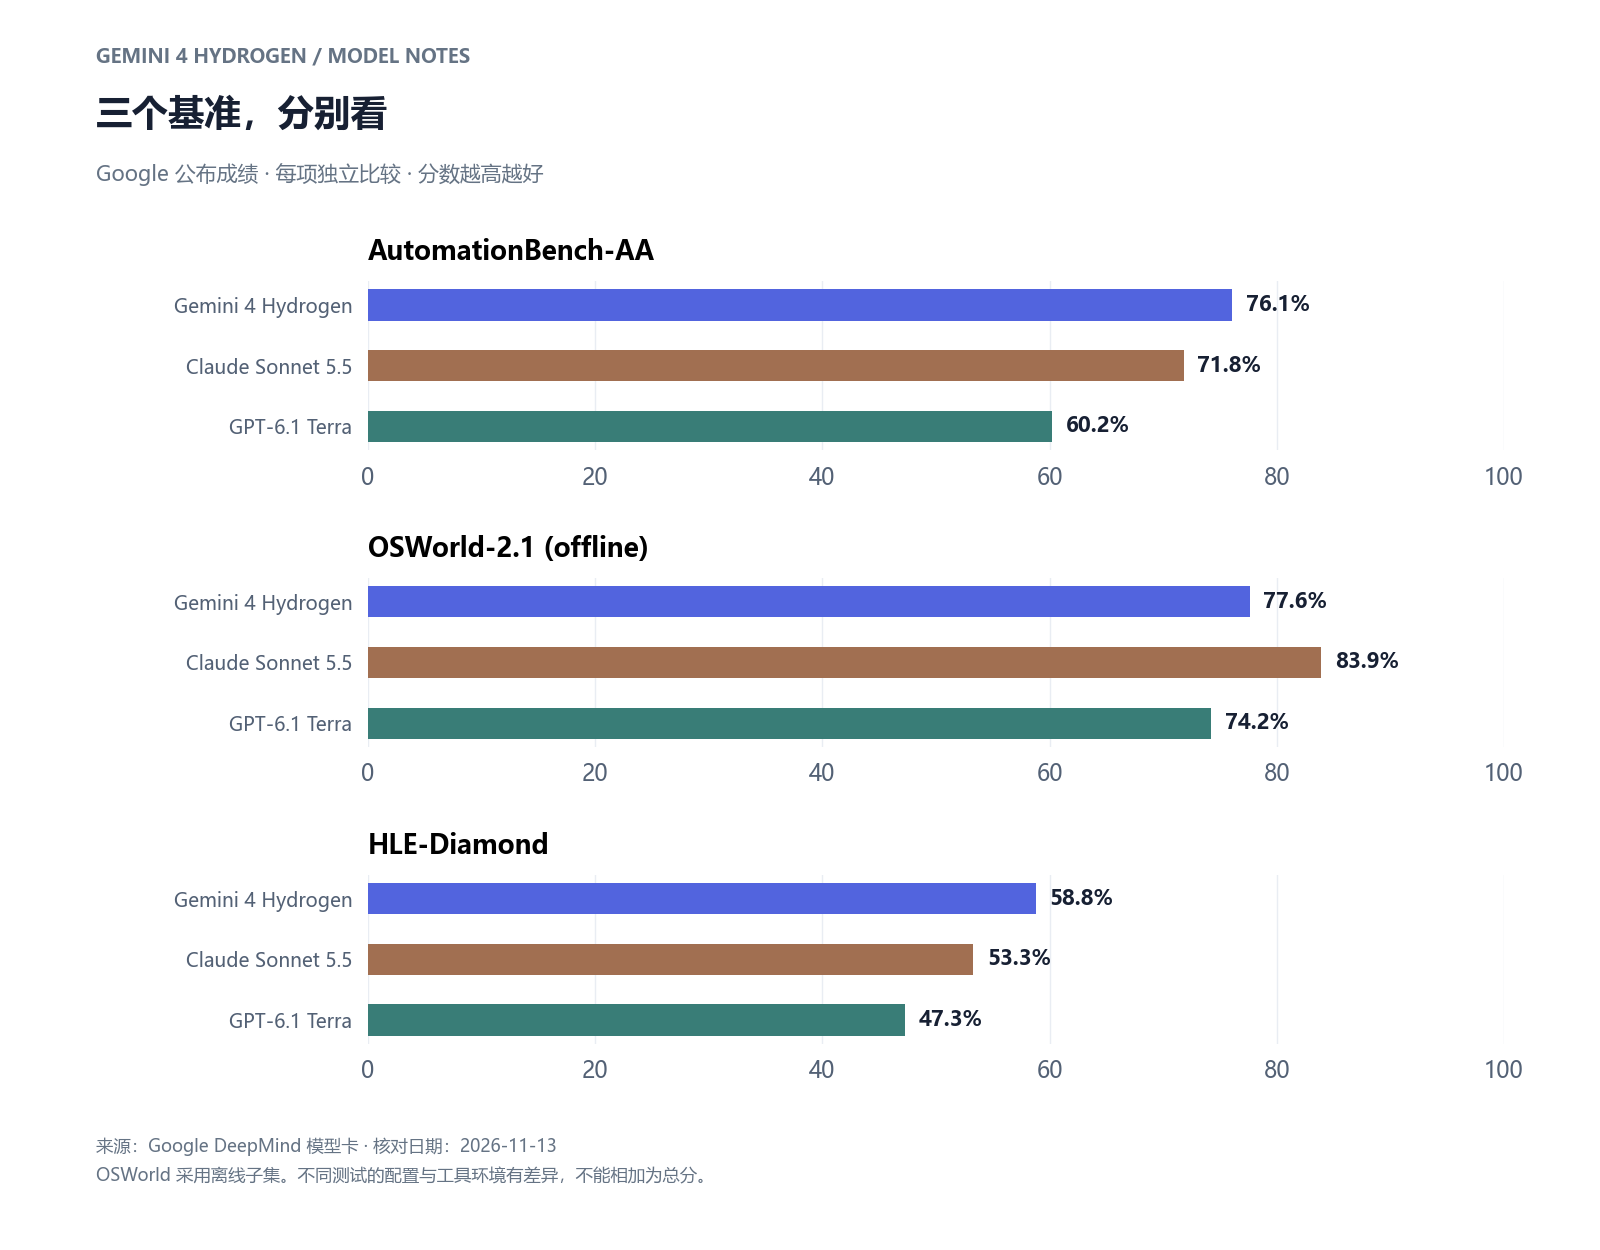
编程成绩也值得单独拆开。Google 表中的 Terminal-Bench 4.1 经过作弊行为调整后,Hydrogen 为 57.0%,Sonnet 5.5 为 63.9%;Terra 这一格没有数据,不能当成零分。这个结果提醒我:修仓库、操作终端、操作桌面,虽然都叫“智能体任务”,难点并不相同。Google 性能对比页 · 评测方法
我会用这些分数缩小试用名单,而不会直接据此替换生产模型。尤其是需要频繁调用工具的应用,模型之外的提示词、超时、重试和结果检查,都可能影响最终交付。
数据分析的满分,让我更愿意实际试一轮
Plotly 的 DataAnalyticsBench 中,Hydrogen 拿到了满分,却不是最快或最便宜的满分模型。对实际选型来说,这比单独一个分数更有参考价值。Plotly 原始报告
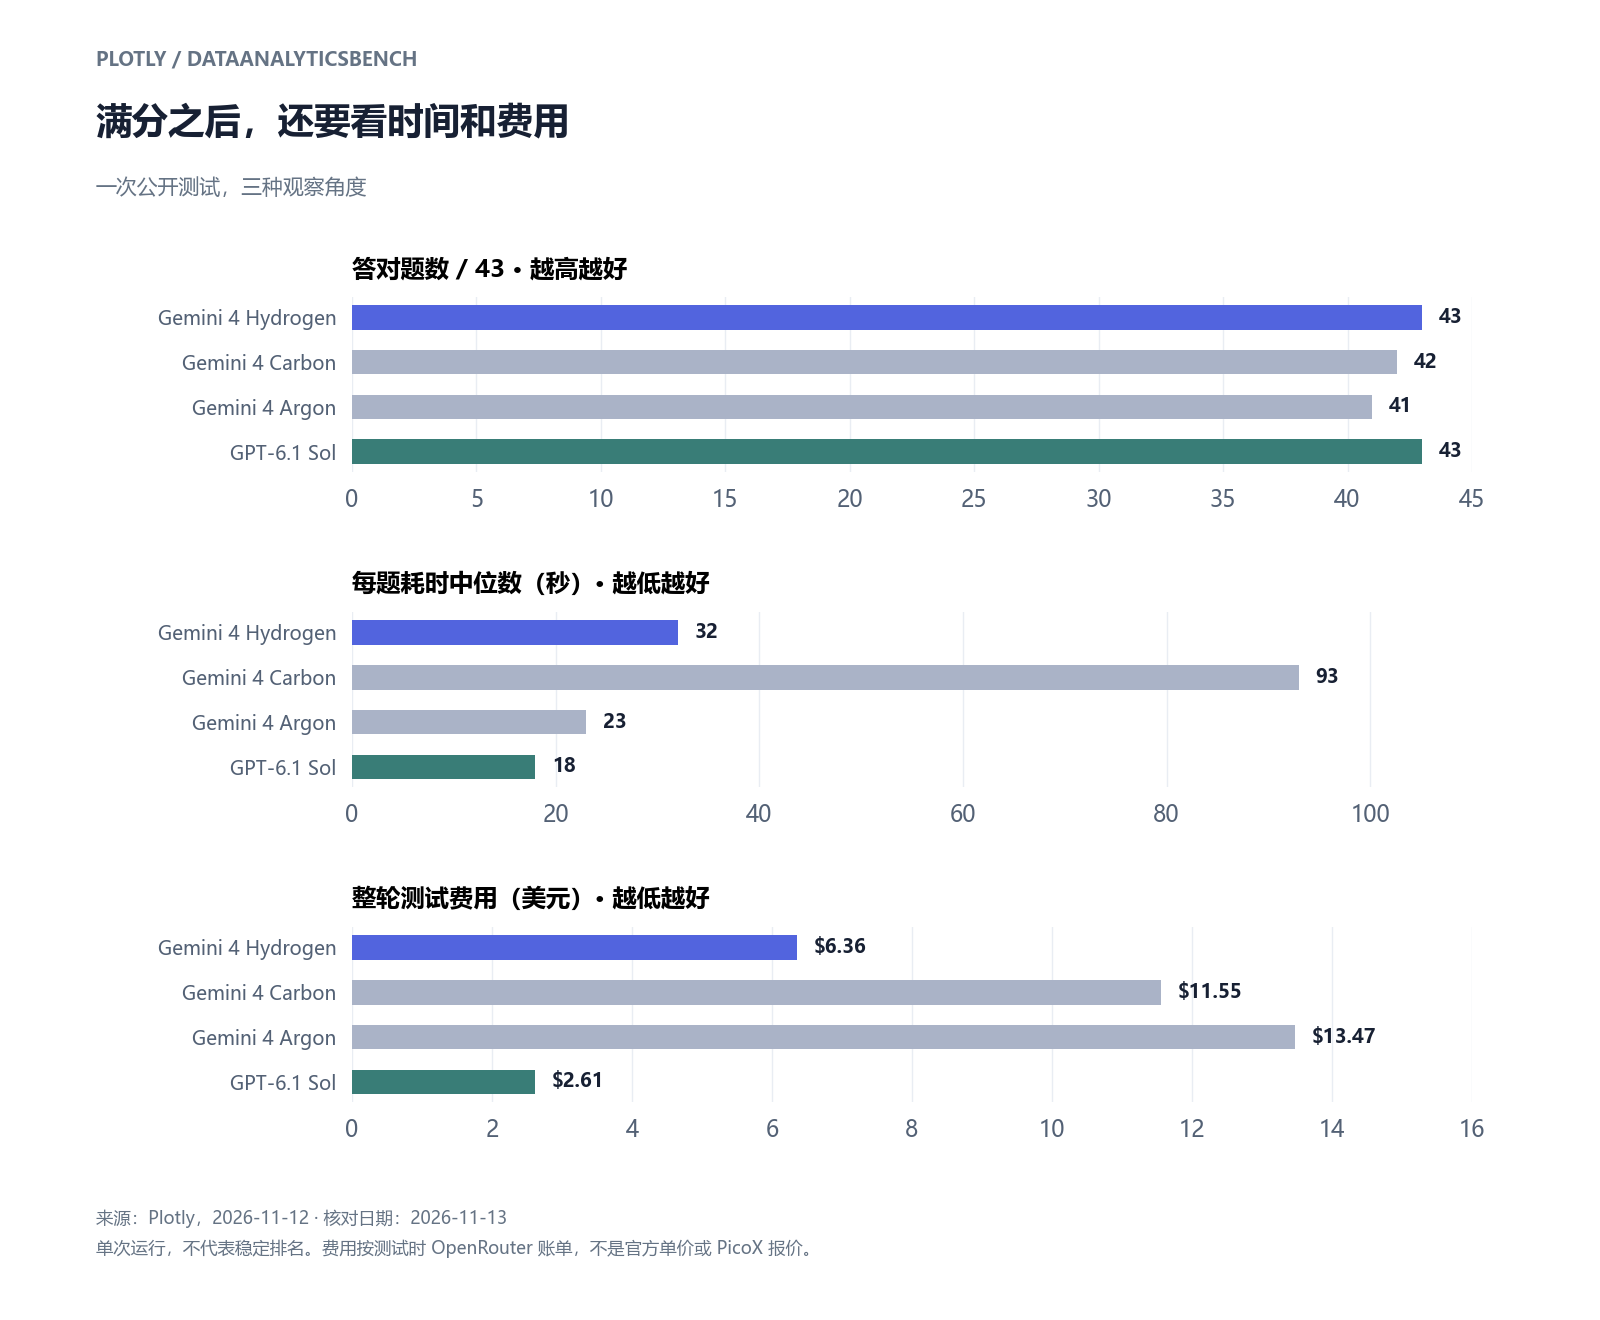
这套测试用的是合成的风电数据仓库和 Plotly Studio Embedded 工具环境,既考分析,也考含糊问题、数据质量和统计陷阱。它更接近“让 Agent 查数据再回答”的场景,而不是让模型凭记忆做一道选择题。测试设计
需要留一点余地:作者明确说每个模型这里只跑了一轮,其他模型复测时曾有最多三题的波动。因此,43 对 42 不能证明稳定领先。我更关心自己的数据里出现缺失值、重复记录或错误口径时,模型会不会先停下来核实。
百万上下文,不等于一次请求随便输出百万 Token
Google Cloud 的发布记录写得很具体:Hydrogen 的输入和输出共享 1,048,576 Token,输出预算还包含思考与函数调用。普通前台请求无论流式还是非流式,单段输出上限都是 65,536 Token。更长生成需要 Google 的续写机制,并且仍要给输入留空间。Cloud 发布记录
这影响的是接入方式,而不只是模型卡上填哪个数字。长文件分析时,输入已经占去大半窗口,就不能再把完整窗口当作可输出额度。通过兼容 API 调用时,也需要确认渠道和客户端是否实现了续写,不能只改一个 max_tokens 就假定能获得同样行为。
| 项目 | 录入与使用时的口径 |
|---|---|
| 官方模型 ID | gemini-4-hydrogen |
| PicoX 模型 ID | google/gemini-4-hydrogen |
| 共享上下文 | 1,048,576 Token |
| 常规单段输出 | 65,536 Token,包含思考 |
| 思考档位 | low / medium / high / xhigh,默认 high |
| 输入与输出 | 文本、图片、音频、视频输入;文本输出 |
| 参数量 | 未公开,不填写推测数字 |
规格参考 Google 模型文档;具体输入类型仍取决于所选渠道和接口支持。
价格不复杂,真正的变量是整个任务用了多少 Token
核对当天,Google Gemini Developer API 的 Standard 美元报价如下。这里只列常规 Token 计费,不把 Batch、Flex 或其他服务商的折扣混进来。输出价格包含思考 Token;当前上下文缓存为隐式缓存。Google 官方价格表
| 计费项 | 每百万 Token |
|---|---|
| 输入 | $1.50 |
| 缓存读取 | $0.075 |
| 输出,含思考 | $7.50 |
举个纯计算例子:10 万个未缓存输入 Token,加上总计 1 万个计费输出 Token,费用是 0.1 × 1.50 + 0.01 × 7.50 = $0.225。如果这 10 万输入全部符合缓存读取计费,算下来是 $0.0825。这里没有包含单独计费的搜索或其他工具,也没有假定每次都能命中缓存。
所以我会把成功率、总耗时和每个完成任务的费用放在一起看。便宜的一次回答,如果后面还要重试三次,未必便宜;同样,把所有任务都调到最高思考档位,也不一定划算。
从 Flash 迁移,先检查这几个参数
Google 的迁移指南要求改用 thinking_level:旧的 thinking_budget 和 MINIMAL 不适用于 Hydrogen;temperature、top_p、top_k 不起作用。已有多轮工具调用还要正确保留 thought_signature。这些是 Google 原生接口的规则,兼容接口如何映射要单独核对。官方迁移指南
我的试用顺序会很朴素:先用默认档位跑一组已知答案的任务,再比较 low 和 medium 是否够用,把 xhigh 留给确实需要它的样本。编程题看测试和最终 diff,分析题查计算口径和证据,工具题专门放几个失败返回。不要只挑一次最漂亮的回答做决定。
总体看,Hydrogen 值得加入日常编程、数据分析和工具型 Agent 的候选名单。它的价值最终应该体现在你少等了多久、少改了多少,以及完成一件事的真实费用上。
PicoX 已加入 Gemini 4 Hydrogen,模型 ID 为 google/gemini-4-hydrogen。登录 控制台模型页面,可以确认当前账号可用的供应商与接入信息,再参考 API 文档配置调用。具体价格和可用渠道以账号内展示为准。